
Sviluppare o acquistare il tuo ERP: quando sviluppare con agenti AI e quando acquistare una piattaforma
Rémi Beges ha sviluppato ERP su misura per produttori prima di cofondare Bonx. Qui mette alla prova la domanda sviluppare o acquistare su 11 criteri e più di 140 fonti pubblicate.

White paper

35 minuti di lettura

about the author
Remi Beges
Cofondatore e CTO
Rémi ha un dottorato in ingegneria elettrica, con specializzazione in semiconduttori. Per anni ha automatizzato processi e sviluppato ERP su misura per aziende manifatturiere, perché sul mercato non trovava nulla all'altezza. Poi ha cofondato Bonx per non dover più reinventare la ruota.
Introduzione
Questo white paper esamina senza giri di parole quando conviene sviluppare un ERP e quando è preferibile acquistarne uno.
Una premessa: Bonx è l’ERP manifatturiero AI-native. Vendiamo una piattaforma ERP, quindi il nostro punto di vista non è neutrale. Ma ogni giorno sviluppiamo anche il nostro software con agenti di programmazione AI e ci interroghiamo anche noi sul valore del nostro prodotto. Se gli agenti possono creare software, perché un’azienda manifatturiera dovrebbe acquistare il nostro?
È la domanda centrale di questo documento: un’azienda industriale dovrebbe sviluppare il proprio ERP con agenti di programmazione AI, oppure acquistare una piattaforma ERP e adattarla?
Per scegliere, ti consigliamo di valutare gli 11 criteri della tabella seguente. Per ciascuno trovi gli aspetti principali da considerare. La sezione successiva riassume i risultati della ricerca e le condizioni che rendono preferibile l’acquisto o lo sviluppo. L’analisi approfondisce poi ogni criterio con dati pubblicati, mentre la sezione finale mostra come si manifestano nel tempo le conseguenze di uno sviluppo mal gestito.
| Criterio | Aspetti da valutare |
|---|---|
| Progettazione tecnica | Chi definisce il modello dei dati, le transazioni e le dipendenze tra moduli |
| Regole gestionali | Importi, date, valorizzazione delle scorte, tracciabilità e operazioni ripetute: regole esplicite e verificate |
| Sicurezza | Regole di accesso lato server, credenziali e altri dati riservati, dipendenze e monitoraggio |
| Prestazioni | Tempi di risposta con anni di dati e picchi di utenti, elaborazioni in background |
| Affidabilità e protezione dei dati | Backup verificati e fuori dalla portata degli agenti, permessi limitati, procedure di rilascio e reperibilità |
| Integrazioni | Comportamento di ogni collegamento quando un messaggio viene perso, ripetuto o ricevuto in ritardo |
| Conformità | Fatturazione elettronica, esportazioni contabili per le verifiche fiscali, traccia di audit, conservazione e tracciabilità |
| Manutenzione | Chi corregge e fa evolvere il sistema, i test e la documentazione |
| Costo | Costo dei modelli per attività, strumenti e tempo del personale |
| Adattabilità | Come vengono gestiti i processi specifici e con quali garanzie di sicurezza |
| Nuove funzionalità | Cosa si può creare con i modelli oltre a un ERP standard, e chi è in grado di farlo |
La nostra conclusione: sviluppare o acquistare il tuo ERP
Dopo aver esaminato tutte le ricerche, siamo arrivati alla conclusione che segue. Nel resto del documento trovi i dettagli per formulare la tua.
Le parti semplici sono diventate più facili. Quelle difficili restano tali.
Se i modelli linguistici continuano a migliorare*, scrivere codice diventa poco costoso. Le ricerche esaminate mostrano progressi concreti nella creazione di nuove applicazioni, nell’ottimizzazione, nella sicurezza e nella conformità alle specifiche, quando esiste una suite di test ufficiale.
Non mostrano però progressi analoghi nel mantenere coerente un’architettura attraverso anni di modifiche, applicare regole gestionali non scritte, garantire la stabilità dei rilasci e la gestione operativa, realizzare integrazioni o rispettare obblighi privi di uno strumento ufficiale di verifica. Neppure il costo di utilizzo dei modelli migliori mostra un miglioramento analogo.
I team esperti ottengono di più dall’AI.
I fornitori di ERP, Bonx compresa, non hanno un’AI segreta e più potente. Usano gli stessi modelli a disposizione di un’azienda manifatturiera. L’AI da sola, quindi, non dà a un produttore un vantaggio sul fornitore: entrambi hanno gli stessi strumenti.
Lo studio più ampio disponibile finora rileva però che gli sviluppatori esperti ottengono quasi tutti i guadagni di produttività dell’AI. I progressi dei modelli tendono quindi ad ampliare il divario tra un team che sviluppa e gestisce ERP da anni e un’azienda che sta creando il suo primo ERP.
In altre parole, man mano che l’AI migliora, i fornitori con team di sviluppatori esperti tenderanno a distanziare ulteriormente le aziende che costruiscono il loro primo ERP. È l’esperienza, più che l’accesso ai modelli, a trasformare l’AI in un prodotto migliore.
In sintesi: Sviluppare un ERP conviene quando la quota di esigenze specifiche dell’azienda si avvicina all’80%. Negli altri casi, i dati sostengono soprattutto l’acquisto di una piattaforma adattabile, su cui sviluppare la parte specifica con l’AI.
*Ipotesi di base, limiti e trasparenza
L’analisi presuppone che i modelli linguistici di grandi dimensioni (LLM) continuino a migliorare. Sono progrediti rapidamente negli ultimi 24-36 mesi e l’analisi assume che continuino a farlo nei prossimi 24-48 mesi.
GDPval misura questi progressi su attività professionali reali. Professionisti appartenenti a 44 categorie professionali, nei nove settori più rilevanti dell’economia statunitense, manifattura compresa, hanno definito attività tratte dal proprio lavoro. Altri professionisti hanno poi confrontato alla cieca il risultato prodotto da un’AI con quello di un professionista.
Il lavoro del modello migliore è stato giudicato almeno pari a quello del professionista nel 12% delle attività a maggio 2024 e nell’85% ad aprile 2026 (GDPval, OpenAI 2025, GPT-5.2, GPT-5.5). Questi dati vanno letti con cautela: gli ultimi due sono pubblicati da OpenAI sui propri modelli e sul proprio benchmark. Inoltre, 220 attività sono pubbliche, quindi i laboratori possono usarle per l’addestramento. La versione indipendente di Artificial Analysis usa valutatori AI anziché professionisti: i suoi punteggi non sono quindi confrontabili (GDPval-AA).

Queste attività forniscono tutto il contesto necessario e vengono svolte in un unico passaggio: l’opposto di un ERP che evolve negli anni. Lo stesso studio considera anche il tempo necessario a un professionista per verificare il lavoro dell’AI e rifarlo quando non è adeguato. Includendo questo tempo, un professionista che usava i modelli testati nel 2025 lavorava all’incirca alla stessa velocità di uno che lavorava da solo: da 0,87 a 1,12 volte la velocità, contro 90-327 volte escludendo la verifica.
Il costo necessario per ottenere un dato livello di capacità scende rapidamente. Rispondere a una domanda scientifica di livello dottorato con le stesse capacità del miglior modello di gennaio 2025 costava allora 0,30 $, contro 0,0004 $ a metà 2026 (Epoch AI). La misura si basa su un benchmark pubblico che i laboratori possono usare per l’addestramento. Parte del calo può quindi derivare dall’ottimizzazione per quelle domande, anziché da una riduzione del costo delle capacità effettive. Il miglior modello disponibile a ogni data non segue la stessa tendenza: circa 0,04 $ per domanda a inizio 2024 e tra 0,07 e 0,10 $ da agosto 2025, perché ogni generazione ragiona più a lungo prima di rispondere (MIT FutureTech, Epoch AI). La sezione sui costi esamina le conseguenze per un ERP.

Per limitare l’effetto del nostro punto di vista, ogni affermazione seguente si basa su dati pubblicati da terzi, con link alla fonte. Riportiamo anche i dati che contraddicono la nostra posizione.
Questo non elimina i limiti dell’analisi. La maggior parte delle misurazioni proviene da benchmark software, non da studi sugli ERP. Gran parte delle evidenze del 2026 è contenuta in studi non ancora sottoposti a revisione tra pari. Le indagini sulle integrazioni riguardano grandi aziende. E il documento resta scritto da un fornitore di ERP: l’uso esclusivo di fonti terze riduce questo limite, senza eliminarlo.
Gli 11 criteri in sintesi
Questa sintesi riassume il resto del white paper. Per ciascun criterio mostra i risultati della ricerca, le prospettive e i casi in cui conviene acquistare o sviluppare. Segue l’analisi completa.
Progettazione tecnica
Risultati della ricerca: Gli agenti AI estendono correttamente un’applicazione esistente circa una volta su tre. Nel 39% dei fallimenti compromettono qualcosa che funzionava.
Prospettive 2027-2030: Creare un prototipo non è più un ostacolo. Mantenere coerente l’architettura nel tempo resta un punto molto debole.
Acquista se: Nessuno in azienda ha le competenze per assumersi la responsabilità del modello dei dati e della struttura.
Sviluppa se: Un ingegnere esperto prende le decisioni strutturali e verifica il lavoro degli agenti.
Regole gestionali
Risultati della ricerca: Su lunghe sequenze di registrazioni contabili, gli agenti migliori producono un bilancio esatto al massimo nel 46% dei casi.
Prospettive 2027-2030: Le regole teoriche sono note. Sequenze lunghe e regole non scritte restano problematiche.
Acquista se: Hai regole personalizzate, ma ti servono anche fondamenta solide nelle funzioni ERP comuni, come scorte e fatturazione.
Sviluppa se: Circa l’80% delle tue regole e dei tuoi processi è specifico della tua attività.
Sicurezza
Risultati della ricerca: Solo il 37% del codice funzionante del miglior agente (settembre 2026) è anche sicuro.
Prospettive 2027-2030: Progressi rapidi, ma gli attaccanti usano gli stessi strumenti.
Acquista se: Nessuno può monitorare, applicare patch e rispondere agli incidenti di sicurezza.
Sviluppa se: Qualcuno in azienda ha le competenze tecniche per gestire la sicurezza.
Prestazioni
Risultati della ricerca: Sulle attività reali di ottimizzazione, il miglior agente raggiunge meno di un quarto del miglioramento di velocità di un esperto.
Prospettive 2027-2030: Grandi progressi quando l’obiettivo è esplicito.
Acquista se: Nessuno sa prendere le decisioni architetturali da cui dipendono le prestazioni, né monitorare e mantenere il sistema.
Sviluppa se: I volumi restano modesti (tabelle sotto le 50.000 righe), non si prevede crescita, qualcuno con competenze tecniche di base controlla le prestazioni e accetti un sistema più lento di un prodotto sviluppato da professionisti. Le sole tabelle di tracciabilità possono superare 1 milione di righe in pochi mesi.
Affidabilità e protezione dei dati
Risultati della ricerca: I team che hanno adottato l’AI hanno avuto rilasci meno stabili nel 2024 e nel 2025.
Prospettive 2027-2030: Nessun miglioramento misurato.
Acquista se: Nessuno sa gestire i backup e verificarne il funzionamento, oppure perdere dati è inaccettabile.
Sviluppa se: Una persona di assoluta fiducia garantisce la protezione dei dati, oppure accetti il rischio di perderli da un giorno all’altro se un agente cancella tutto.
Integrazioni
Risultati della ricerca: Gli sviluppatori dedicano il 39% del tempo a creare nuove integrazioni.
Prospettive 2027-2030: I connettori si scrivono più velocemente, ma aumentano i sistemi da collegare.
Acquista se: I collegamenti necessari esistono già sulla piattaforma.
Sviluppa se: I collegamenti sono davvero specifici della tua attività, per esempio con software di nicchia o macchine particolari.
Conformità
Risultati della ricerca: Gli agenti si avvicinano al 100% quando una suite ufficiale di test verifica la regola, contro il 44-76% quando esiste solo come testo.
Prospettive 2027-2030: Progressi dove esistono verifiche automatiche, ma le regole cambiano ogni anno.
Acquista se: Gli obblighi sono quelli comuni: fatturazione elettronica, esportazioni contabili e tracciabilità.
Sviluppa se: Gli obblighi sono specifici del settore e un esperto li trasforma in controlli.
Manutenzione
Risultati della ricerca: La manutenzione assorbe il 40-80% del costo del software durante la sua vita. È una stima classica, precedente agli agenti di programmazione.
Prospettive 2027-2030: L’AI produce più codice da mantenere, comprese più duplicazioni.
Acquista se: Nessuno conoscerà il codice abbastanza da correggerlo e modificarlo per tutta la vita dell’ERP.
Sviluppa se: L’azienda può contare nel tempo su persone che conoscono il codice e sanno correggerlo e modificarlo finché l’ERP viene usato.
Costo
Risultati della ricerca: Un sistema sviluppato internamente costa 1,7-5 volte il costo iniziale durante la sua vita. Negli Stati Uniti uno sviluppatore costa circa 200.000 $ l’anno.
Prospettive 2027-2030: Il costo dello sviluppo diminuisce più di quello della manutenzione, mentre il modello migliore costa di più per attività.
Acquista se: Hai pochi utenti rispetto al team necessario per sviluppare e mantenere il sistema, ed è meglio destinare la liquidità all’attività.
Sviluppa se: Hai molti utenti, un team di sviluppo già presente e preferisci avere un software di tua proprietà sostenendo costi fissi di personale.
Adattabilità
Risultati della ricerca: Il 38% delle aziende ha piegato i propri processi alle esigenze dell’ERP.
Prospettive 2027-2030: Adattare una piattaforma costa sempre meno.
Acquista se: La piattaforma può essere adattata sui tuoi dati senza toccarne il nucleo.
Sviluppa se: La piattaforma si adatta solo modificandone il codice centrale, oppure circa l’80% delle tue esigenze è specifico, anziché il 20%.
Nuove funzionalità
Risultati della ricerca: Su 160.097 sviluppatori, quelli esperti ottenevano quasi tutti i miglioramenti di produttività e nella capacità di esplorare nuovi ambiti grazie all’AI.
Prospettive 2027-2030: Tutti hanno gli stessi modelli, ma i team esperti ne ottengono di più.
Acquista se: Impiegheresti le tue risorse per ricostruire funzioni standard.
Sviluppa se: Hai un team di sviluppo e di prodotto capace di creare ciò che nessuna piattaforma offre.
Criterio 1: Progettazione tecnica
Nel caso migliore: un’architettura coerente mantiene il sistema veloce e stabile durante la crescita e limita il costo di ogni modifica.
Nel caso peggiore: il sistema viene progettato di volta in volta in risposta alle singole richieste, senza una struttura coerente. Le correzioni si accumulano senza risolvere i difetti strutturali e ogni modifica diventa più lenta e rischiosa.
Verdetto
Oggi: gli agenti individuano i componenti di un sistema, ma ne definiscono male le relazioni. Riescono quasi sempre a creare un’applicazione nuova, ma falliscono due volte su tre quando devono continuare a modificarne una esistente, spesso causando regressioni.
Dal 2027 al 2030: gli agenti continueranno a migliorare nella scrittura di nuovo codice. I dati non mostrano ancora che sappiano mantenere coerente un’architettura attraverso anni di modifiche, come richiede un ERP. Un’azienda senza personale tecnico che sviluppa il proprio ERP da zero con gli agenti avrà le prime schermate in poche settimane. Ogni richiesta successiva verrà gestita isolatamente: una nuova tabella qui, una regola copiata lì. Dopo uno o due anni, le modifiche inizieranno a compromettere ciò che funzionava, senza che nessuno in azienda sappia spiegare perché o correggere la struttura. A quel punto sarà probabilmente necessario abbandonare il software, perdendo l’investimento, che potrebbe ormai ammontare a diversi milioni di dollari, anche con un uso intenso dell’AI e un piccolo team di sviluppo interno.
Evidenze
La domanda è cosa succede quando è un modello linguistico di grandi dimensioni (LLM), anziché un ingegnere, a prendere le decisioni strutturali: modello dei dati, confini delle transazioni, dipendenze tra moduli e così via.
- Fred Brooks scriveva che «l’integrità concettuale è il criterio più importante nella progettazione di un sistema» (The Mythical Man-Month, cap. 4). David Parnas ha mostrato che le modifiche apportate senza comprendere il progetto originario ne degradano la struttura finché nessuno capisce più il prodotto (Software Aging, ICSE 1994).
- In sette progetti Apache, i difetti architetturali assorbivano il 51-85% dell’impegno di manutenzione. I cinque difetti peggiori riguardavano l’8-25% dei file più soggetti a errori, ma richiedevano il 20-61% dell’impegno. Il loro costo cresceva nel tempo (Xiao et al., ICSE 2016).
- Gli agenti scelgono framework e infrastruttura, ma quasi nessuno verifica queste scelte come decisioni architetturali. La sola formulazione del prompt ha prodotto sistemi strutturalmente diversi per la stessa attività (Konrad et al., aprile 2026).
- Chiamati a trasformare i requisiti di 68 progetti in un’architettura, i modelli individuavano la maggior parte dei componenti, ma nella definizione delle relazioni tra loro raggiungevano al massimo 0,18 su 1. Circa un terzo delle scelte progettuali non aveva fondamento nei requisiti. Le relazioni inventate erano l’errore più comune (R2ABench, 2026).
- Su 3.275 attività di normalizzazione di database, i modelli fallivano ripetutamente nel dedurre le dipendenze tra dati e ricostruire i vincoli tra tabelle (DNBench, settembre 2026).
- Chiamati a ricreare 200 programmi esistenti, dagli strumenti a riga di comando a SQLite, nessun modello ne ricostruiva completamente uno nello studio originale. Nella classifica di settembre 2026, il modello migliore ne risolve completamente il 4,5% e quasi completamente il 37% (ProgramBench).
- Creare una nuova applicazione web da una specifica è un problema quasi risolto: il modello migliore raggiunge il 92% sulla versione attuale di Vibe Code Bench, contro il 41% a febbraio 2026, in parte grazie a una revisione del benchmark (Vals.ai). Far evolvere un’applicazione esistente attraverso 10 richieste successive non lo è: il miglior punteggio è il 34% e il 39% dei fallimenti provoca una regressione (VCB 1-100).
- Gli architetti intervistati e coinvolti nelle indagini del 2026 usano l’AI per attività meccaniche e raramente per decisioni legate al contesto del progetto (Felder et al., FSE 2026).
- In un benchmark in cui gli agenti estendono la stessa base di codice in molti passaggi, il degrado strutturale aumentava nell’80% delle esecuzioni. Il codice degli agenti era 2,2 volte più lungo di quello scritto da persone. Prompt migliori aumentavano la qualità iniziale, ma non rallentavano il deterioramento (SlopCodeBench, marzo 2026).
- Dopo l’adozione dell’editor AI Cursor, lo sviluppo di 806 progetti open source accelerava per uno o due mesi, poi rallentava mentre il codice diventava più complesso e difficile da modificare (Carnegie Mellon, MSR 2026).
- In senso opposto, uno studio su 151 progetti Java non ha rilevato variazioni nei problemi architetturali dopo l’adozione degli agenti, mentre il volume del codice cresceva del 12,8% (Larsen e Moghaddam, giugno 2026).
La maggior parte delle evidenze recenti proviene da prepubblicazioni del 2026 e uno studio non rileva effetti. Emerge comunque una tendenza coerente: i modelli gestiscono bene le singole parti di un progetto, ma perdono coerenza nelle relazioni tra le parti e nelle modifiche successive. Un ERP viene modificato per anni: proprio la situazione in cui gli agenti ottengono i punteggi più bassi. Il risultato è in linea con 50 anni di ricerca nell’ingegneria del software, secondo cui la qualità di un sistema dipende dalle prime decisioni strutturali (Roychoudhury e Zeller, 2025).
Criterio 2: Regole gestionali
Nel caso migliore: le regole comuni a tutte le aziende vengono applicate correttamente ovunque: importi, date, valorizzazione delle scorte, tracciabilità e così via.
Nel caso peggiore: piccoli errori passano inosservati e si ripercuotono sulla contabilità, sul bilancio o sull’individuazione dei lotti da richiamare.
Verdetto
Oggi: gli agenti conoscono le regole teoriche, ma spesso sbagliano ad applicare quelle gestionali in assenza di verifiche: producono bilanci esatti al massimo nel 46% dei casi su lunghe sequenze di registrazioni, accettano ordini con quantità negative e scrivono codice anziché fare domande quando manca una regola.
Dal 2027 al 2030: i progressi dei modelli non forniranno le regole che nessuno ha scritto. Gli errori vengono individuati solo se qualcuno esplicita le regole e le verifica automaticamente. Un’azienda senza personale tecnico che sviluppa l’ERP da zero avrà schermate apparentemente corrette e cifre leggermente sbagliate: una differenza di arrotondamento su ogni fattura, scorte valorizzate in due modi diversi, un utente che vede margini a cui non dovrebbe avere accesso. Questi errori resteranno invisibili finché una chiusura d’esercizio, una verifica fiscale o un richiamo non li rivelerà.
Evidenze
Alcune regole sono universali. Gli importi si calcolano con decimali esatti e si arrotondano in punti definiti. Un’operazione ripetuta dopo un errore di rete non deve essere applicata due volte. Le date vengono registrate con il fuso orario. Due aggiornamenti simultanei delle stesse scorte non devono sovrascriversi. Ogni registrazione contabile deve essere in pareggio. Le scorte devono essere valorizzate con un unico metodo coerente.
- Su 392 attività di sviluppo backend, circa metà dei programmi funzionalmente corretti presentava vulnerabilità sfruttabili da un attaccante. A seconda dell’attività, controlli di accesso inadeguati comparivano nel 22-51% dei risultati corretti. Una specifica precisa dell’interfaccia migliorava la correttezza di 7-9 punti, mentre un richiamo generico alla sicurezza cambiava pochissimo (BaxBench, ICML 2025).
- Quando cinque agenti hanno creato tre applicazioni ciascuno, quattro applicazioni accettavano ordini con quantità negative e tre accettavano prezzi negativi, perché la richiesta non lo vietava (SecurityWeek, gennaio 2026).
- Uno studio ha esaminato direttamente importi, date e operazioni ripetute. Nel codice backend scritto da cinque modelli di punta per 50 attività senza specifica, ha contato 66 difetti sugli importi (virgola mobile, arrotondamenti), 32 sulle operazioni ripetute, 31 sulle date e 19 sugli accessi. Una specifica di 267 parole li riduceva dell’84%. È l’unico studio di questo tipo finora, scritto da un solo autore che ha realizzato anche gli strumenti di verifica, e non è stato sottoposto a revisione tra pari (Dhuri, settembre 2026).
- I modelli di punta gestiscono gli esercizi classici di partita doppia: Gemini 3 superava 16 controlli su 16 e Claude Opus 4.5, 15/16 (Modern Treasury, gennaio 2026, quattro scenari, test del fornitore).
- Su sequenze più lunghe, sei modelli producevano un bilancio esatto al massimo nel 46% dei casi, con uno scarto di 26-41 punti tra il loro bilancio e quello ricalcolato dalle loro stesse registrazioni (FinBalance, giugno 2026). Su 160 attività contabili di livello esperto, il modello migliore raggiungeva il 56,4%. Nessuno superava il 2,6% quando doveva riuscire nella stessa attività otto volte di seguito (APEX-Accounting, luglio 2026).
- I test unitari non possono esplorare tutti gli ordini di esecuzione delle operazioni simultanee, quindi approvano anche codice concorrente difettoso (CONCUR, 2026).
- Quando manca un requisito, i modelli scrivono codice anziché fare domande in oltre il 60% dei casi (HumanEvalComm, ACM TOSEM 2025). Gli agenti recenti non chiedono quasi mai chiarimenti, salvo istruzioni esplicite (Ambig-SWE, ICLR 2026). I modelli indovinano un requisito non scritto nel 41% dei casi (Carnegie Mellon).
I modelli di punta conoscono le regole teoriche. Falliscono sulle sequenze lunghe, sulle operazioni simultanee e sulle regole non scritte. Le specifiche precise e verificabili aiutano; i richiami generici no. In ogni caso, qualcuno deve conoscere le regole e metterle per iscritto.
Criterio 3: Sicurezza
Nel caso migliore: prezzi, margini, ricette e dati dei clienti restano protetti e la produzione continua.
Nel caso peggiore: furto di dati o ransomware. Dopo il cyberattacco del 2025 a Jaguar Land Rover, la produzione si è fermata per circa cinque settimane, con un costo per l’economia britannica stimato in 1,9 miliardi di sterline sulla base di un modello (Cyber Monitoring Centre).
Verdetto
Oggi: il miglior agente scrive codice che funziona ed è anche sicuro in circa un terzo delle attività. Le applicazioni create in questo modo espongono già dati e chiavi di accesso su larga scala.
Dal 2027 al 2030: al ritmo attuale, gli agenti scriveranno codice sicuro nella maggior parte delle attività prima del 2030. Ma gli attaccanti usano gli stessi modelli e nel 2025 alcune vulnerabilità venivano già sfruttate prima che esistesse una correzione. Per un’azienda senza personale tecnico che sviluppa il proprio ERP da zero, il rischio principale è che nessuno lo controlli una volta avviato: niente monitoraggio, nessuna patch, nessun piano in caso di attacco. Una chiave esposta o una libreria obsoleta possono restare vulnerabili per mesi, finché una fuga di dati o un ransomware non ferma la produzione.
Evidenze
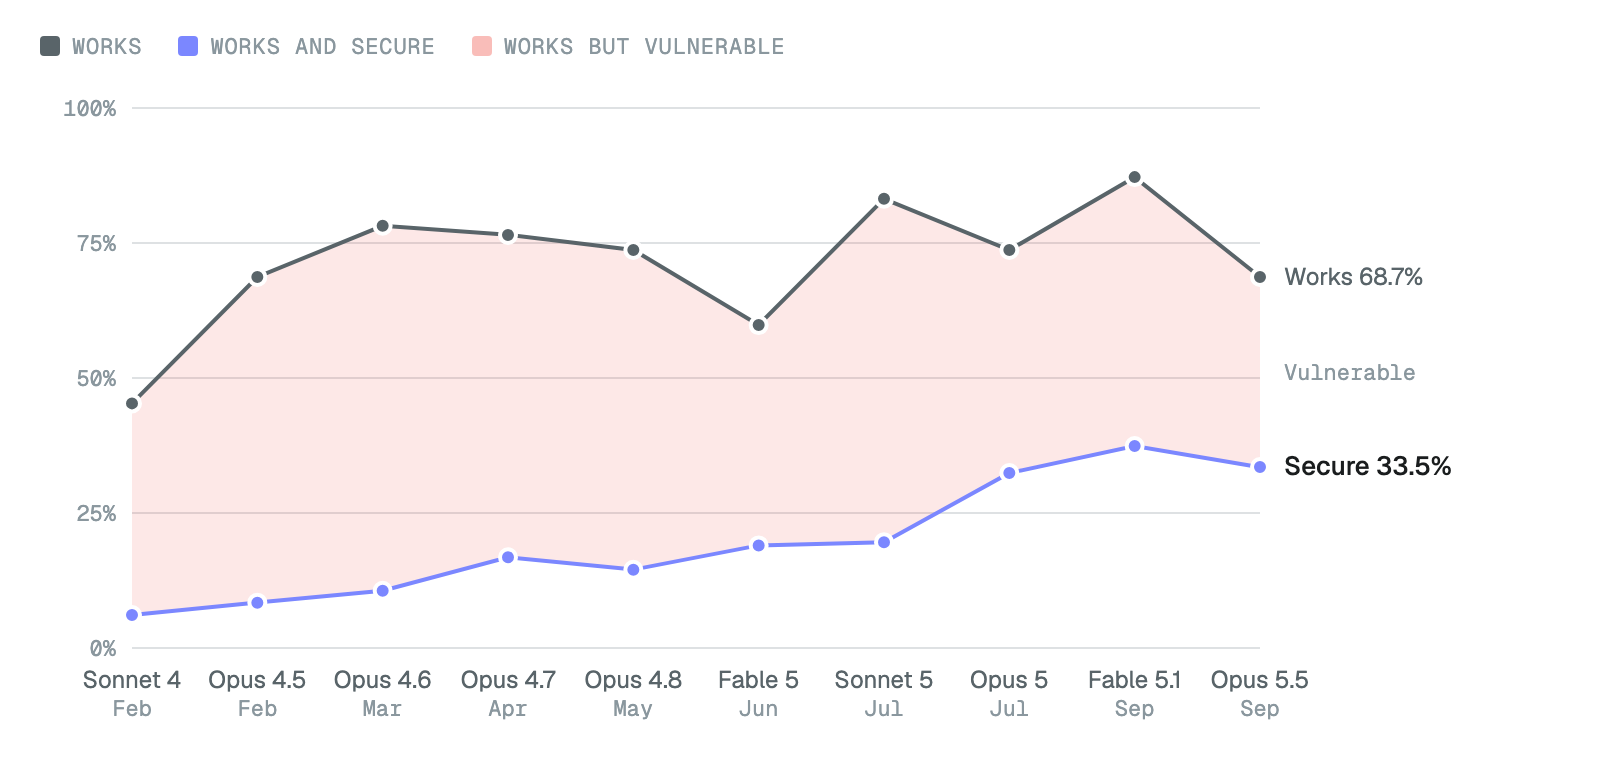
- Nel benchmark di Endor Labs, la quota di codice funzionante e sicuro è salita dal 6% al 37% tra febbraio e settembre 2026. Con la migliore combinazione di agente e modello misurata, il 57% del codice funzionante resta vulnerabile.
- Veracode testa i modelli senza agente. La media è rimasta al 55% di codice sicuro nel 2025 e al 56% nel 2026, mentre oltre il 95% del codice compila. Aggiungere indicazioni di sicurezza al prompt non ha prodotto riduzioni statisticamente significative delle vulnerabilità (Kharma et al., maggio 2026).
- Un’analisi di 5.600 applicazioni pubbliche create tramite generazione di codice ha trovato oltre 2.000 vulnerabilità, più di 400 credenziali e altri dati riservati esposti e 175 esposizioni di dati personali (Escape.tech, ottobre 2025). Su 1.645 applicazioni Lovable, 170 consentivano a chiunque di leggerne i dati (CVE-2025-48757).
- I commit effettuati con Claude Code esponevano credenziali e altri dati riservati nel 3,2% dei casi, contro una media dell’1,5% su GitHub (GitGuardian, 2026).
- Gli attaccanti usano gli stessi modelli. In una campagna di spionaggio descritta da Anthropic a novembre 2025, l’AI ha svolto l’80-90% del lavoro. Mandiant ha rilevato che nel 2025 le vulnerabilità venivano sfruttate in media sette giorni prima che esistesse una patch.
La sicurezza del codice scritto dagli agenti migliora rapidamente partendo da un livello basso, ma cresce anche la capacità di attacco.
Criterio 4: Prestazioni
Nel caso migliore: schermate e calcoli restano veloci mentre si accumulano anni di dati: milioni di movimenti di magazzino, decine di utenti al cambio turno, un calcolo dei fabbisogni sull’intera distinta base, una scansione sulla linea di produzione che deve restituire subito un risultato.
Nel caso peggiore: schermate lente in reparto ed elaborazioni notturne che non terminano: problemi che emergono mesi dopo il go-live.
Verdetto
Oggi: gli agenti ottimizzano bene il codice quando ricevono una richiesta esplicita e un obiettivo misurabile. Per impostazione predefinita, il loro codice è meno efficiente di quello di un esperto. Falliscono più spesso in presenza di vincoli sul database e sull’architettura, scrivono codice d’infrastruttura corretto meno di una volta su cinque e raramente misurano le prestazioni di propria iniziativa.
Dal 2027 al 2030: l’ottimizzazione con un obiettivo esplicito mostra progressi più rapidi rispetto a tutti gli altri ambiti esaminati qui e dovrebbe raggiungere il livello esperto. Nulla nei dati mostra che gli agenti sappiano definire da soli quegli obiettivi o prendere le decisioni d’infrastruttura. Un’azienda senza personale tecnico che sviluppa il proprio ERP da zero avrà un sistema che funziona bene sui dati di test. Con l’accumularsi di anni di movimenti di magazzino, le schermate rallenteranno in reparto e le elaborazioni notturne non finiranno più in tempo. Nessuno saprà se serva un indice, una coda di elaborazione o una nuova architettura.
Evidenze
- Su 1.000 problemi, il codice scritto da GPT-4 era in media 3,12 volte più lento della soluzione di riferimento, fino a 13,9 volte più lento e con 43,9 volte più memoria nei casi peggiori (EffiBench, NeurIPS 2024). Su sei linguaggi, il codice del modello migliore raggiungeva circa il 62% dell’efficienza di quello di un esperto (EffiBench-X, 2025).
- Su 498 attività reali di ottimizzazione, Claude 4.5 Opus otteneva 0,225 volte il miglioramento di velocità dell’esperto, contro 0,024 per Claude 3.7 Sonnet (SWE-fficiency, ICML 2026). Su GSO, le attività di ottimizzazione risolte sono passate dal 3,8% a maggio 2025 all’88,2% a settembre 2026, in parte perché l’ambiente di test ha iniziato a chiedere agli agenti di continuare a ottimizzare.
- I modelli per la programmazione in genere non soddisfano requisiti non funzionali come efficienza e robustezza (NoFunEval, COLM 2024). L’aggiunta di vincoli architetturali e sul database riduceva il tasso di successo di 27 punti in media. I vincoli sul database erano i più penalizzanti (Constraint Decay, 2026).
- Gran parte delle prestazioni di un ERP dipende da scelte tecniche d’infrastruttura che nessuna richiesta all’agente menziona. Due esempi: un’operazione lunga, come il calcolo dei fabbisogni sull’intera distinta base, può essere eseguita in background tramite una coda o bloccare la schermata fino alla conclusione. Un messaggio tra due sistemi può essere consegnato al massimo una volta, con il rischio di perderlo; almeno una volta, con il rischio di applicarlo due volte; oppure di fatto una volta sola tramite deduplicazione, con un maggiore lavoro di progettazione (Kleppmann, appunti delle lezioni di Cambridge). Gli agenti faticano a gestire queste scelte.
- Il primo benchmark di codice d’infrastruttura per AWS rilevava che GPT-4 era corretto nel 19,4% dei casi, contro l’86,6% sulle normali attività Python (IaC-Eval, NeurIPS 2024). Aggiungere conoscenze sulla configurazione portava il successo dal 27% al 63%, ma la corrispondenza con ciò che l’utente voleva davvero smetteva di migliorare. Gli autori riassumono il risultato così: i modelli scrivono bene il codice, ma progettano male (Nekrasov et al., dicembre 2025).
- In un test del 2026, il codice Terraform scritto da Claude Opus 4 superava lo scanner di sicurezza Checkov nel 23,1% dei casi (SBSeg 2026). Esplicitare in dettaglio i requisiti non funzionali migliora il codice degli agenti (Pereira e Garcia, agosto 2026). Inoltre, il 35,2% del codice generato è meno robusto di quello umano, soprattutto per la mancanza di controlli (Li et al., 2025).
- Le modifiche scritte dagli agenti includono verifiche delle prestazioni meno spesso di quelle umane: 45,7% contro 63,6% (dicembre 2025). Nessuno studio pubblicato misura il comportamento sotto carico di un’applicazione aziendale scritta da un agente.
I modelli migliorano molto quando le prestazioni sono un obiettivo esplicito. Altrimenti, il loro codice resta meno efficiente di quello di un esperto e le scelte d’infrastruttura vengono affrontate solo se qualcuno lo chiede.
Criterio 5: Affidabilità e protezione dei dati
Nel caso migliore: l’ERP è disponibile ogni volta che lo stabilimento è operativo e lo storico resta integro.
Nel caso peggiore: un’interruzione blocca le spedizioni. Perdere lo storico dei movimenti di magazzino o il portafoglio ordini aperti impedisce di fatturare ciò che è stato spedito, valorizzare le scorte o rintracciare un lotto durante un richiamo. Per le PMI manifatturiere, un’ora di fermo produttivo può costare fino a 150.000 $ (Siemens, True Cost of Downtime 2024, misurazione riferita al fermo macchina).
Verdetto
Oggi: agenti e automazione hanno già distrutto dati di produzione, sia nelle piccole aziende sia in gruppi delle dimensioni di Amazon. Sono stati recuperati soltanto i dati conservati fuori dalla loro portata. Gli agenti che gestiscono i sistemi risolvono al massimo circa metà degli incidenti reali e l’adozione dell’AI resta associata a rilasci meno stabili.
Dal 2027 al 2030: gli agenti avranno più autonomia e più accessi, quindi una singola azione sbagliata potrà coinvolgere più dati. La protezione dipende dalla configurazione: copie inaccessibili agli agenti, eliminazione differita, permessi ristretti e ripristini testati regolarmente. Un’azienda senza personale tecnico che sviluppa il proprio ERP da zero tenderà a dare all’agente ampi accessi per farlo lavorare velocemente, lasciando raggiungibili con gli stessi permessi anche i backup, come nel caso PocketOS. Potrebbe accorgersi della perdita solo quando servono i dati per una fattura, un inventario o un richiamo.
Evidenze
- Nell’indagine DORA 2024, su circa 3.000 professionisti, ogni aumento del 25% nell’adozione dell’AI era associato a una riduzione del 7,2% della stabilità dei rilasci. Nell’indagine DORA 2025, con quasi 5.000 partecipanti, il legame con la velocità di rilascio diventava positivo, ma quello con la stabilità restava negativo.
- SWE-bench raccoglie bug reali segnalati in progetti open source molto diffusi. Una correzione dell’AI è considerata riuscita quando supera i test del progetto (SWE-bench). Quando i responsabili dei progetti hanno esaminato 296 correzioni di agenti che avevano superato quei test, circa metà non sarebbe stata accettata (METR, marzo 2026).
- Gestire i sistemi è ancora più difficile. Gli agenti risolvevano l’11,4% degli scenari di affidabilità di ITBench (ICML 2025). Su 59 incidenti Kubernetes, tutti i modelli restavano sotto il 50% al lancio di maggio 2026 (ITBench-AA). Nei guasti con cause multiple o di basso livello, il successo scendeva al 15-28% (SREGym, NeurIPS 2026).
Agenti e automatismi con accesso ai sistemi di produzione hanno già distrutto dati aziendali su larga scala:
| Data | Organizzazione | Cosa è successo | Dati recuperati |
|---|---|---|---|
| Ott. 2026 | TV4 | Il montaggio finito di una stagione televisiva è andato perso e la prima è stata rinviata al 2027. Secondo la stampa, lo avrebbe eliminato un agente AI con accesso al server. TV4 nega l’intervento di un agente autonomo e afferma che il backup non ha funzionato (Metro Mode). | No |
| Apr. 2026 | PocketOS | Un agente Cursor con Claude Opus 4.6 ha trovato un token valido per l’intero account e ha eliminato il database di produzione e i backup in circa 9 secondi (Railway). | Recuperati dal fornitore del servizio di hosting, che ha poi introdotto l’eliminazione differita |
| Mar. 2026 | Amazon retail | Interruzioni del negozio online, con circa 120.000 e 6,3 milioni di ordini persi secondo documenti interni riportati dalla stampa. Una nota interna cita modifiche assistite dall’AI. Amazon afferma che un incidente riguardava un consiglio che un agente aveva ricavato da un wiki obsoleto, senza codice scritto dall’AI (Fortune, Amazon). | Vendite perse, non registrazioni cancellate. Ora serve l’approvazione di un responsabile esperto per le modifiche assistite dall’AI |
| Mar. 2026 | Meta | Un agente interno ha pubblicato un consiglio senza approvazione. Un dipendente lo ha seguito e dati aziendali e degli utenti sono rimasti accessibili a ingegneri non autorizzati per circa due ore. L’incidente è stato classificato al secondo livello di gravità più alto (TechCrunch). | Nessun uso improprio segnalato |
| Feb. 2026 | DataTalks.Club | Claude Code ha avviato la distruzione dell’infrastruttura con una configurazione obsoleta, eliminando un database di produzione con 2,5 anni di dati e le copie istantanee visibili all’agente (analisi dell’incidente). | Ripristinati dopo 24 ore da una copia istantanea nel cloud nascosta all’agente |
| Dic. 2025 | Amazon Web Services | Un servizio è rimasto indisponibile per 13 ore dopo che l’agente di programmazione Kiro aveva scelto di eliminare e ricreare l’ambiente in cui operava, secondo il Financial Times (The Decoder). Amazon attribuisce l’incidente a controlli di accesso configurati male e afferma che è stato coinvolto un solo servizio in una sola regione (Amazon). | Nessuna perdita di dati segnalata; causa contestata |
| Mag. 2024 | UniSuper | Un processo automatico di Google Cloud ha eliminato il cloud privato di un fondo pensione con 647.000 iscritti, in entrambe le regioni (comunicato congiunto). | Sì, dopo circa due settimane, da backup presso un altro fornitore |
| Ago. 2020 | KPMG | Una regola di conservazione destinata a un utente è stata applicata a tutto l’ambiente aziendale e ha cancellato le chat Teams di circa 145.000 dipendenti (The Register). | No, secondo una nota interna |
| Gen. 2017 | GitLab | Un ingegnere ha cancellato il database di produzione e tutti e cinque i metodi di backup hanno fallito (analisi dell’incidente). | Sei ore di dati perse definitivamente |
Diversi resoconti su Amazon e TV4 sono contestati: la tabella presenta entrambe le versioni. Uno studio su 344 incidenti AI rilevanti per le aziende ne ha trovati 188 in cui un sistema autonomo aveva causato danni senza alcun attaccante, comprese 65 cancellazioni di dati o codice (Cyera Research, maggio 2026). Nemmeno il ripristino è garantito: tra 900 organizzazioni colpite da un attacco nel 2024, solo il 10% ha recuperato più del 90% dei dati (Veeam 2025).
Queste perdite sono avvenute in aziende con team tecnici esperti: acquistare non elimina quindi il rischio. Un’azienda priva di quelle competenze è più esposta e potrebbe non sapere di aver perso dati finché non ne ha bisogno. In tutti i casi di recupero, i dati provenivano da una copia fuori dalla portata del sistema guasto: una copia istantanea nascosta, un’eliminazione differita o un backup presso un altro fornitore.
Criterio 6: Integrazioni
Nel caso migliore: i dati inseriti una volta arrivano alla contabilità, ai clienti, ai trasportatori e alle macchine.
Nel caso peggiore: una fattura creata due volte, un avviso di spedizione duplicato, un ERP e un sistema contabile con dati discordanti senza alcuna segnalazione, e personale che reinserisce i dati a mano.
Verdetto
Oggi: per gli agenti è facile scrivere un connettore. La parte difficile è decidere cosa accade quando un messaggio viene perso, ripetuto o ricevuto in ritardo, e applicare la stessa regola ovunque. Nulla di questo compare in una semplice richiesta di collegamento.
Dal 2027 al 2030: i sistemi da collegare aumentano e ogni terza parte continua a cambiare la propria interfaccia. Il lavoro di progettazione cresce quindi anziché diminuire, qualunque codice sappiano scrivere i modelli. Un’azienda senza personale tecnico che sviluppa il proprio ERP da zero avrà collegamenti funzionanti il primo giorno. Ai primi problemi, come un timeout durante l’esportazione di una fattura o un messaggio del trasportatore ricevuto due volte, troverà duplicati e discrepanze tra ERP e contabilità, senza che nessuno sappia quale sistema abbia il dato corretto.
Evidenze
L’integrazione è un problema di sistemi distribuiti e le sue difficoltà sono ben documentate.
- Nel 1994, Peter Deutsch elencò le ipotesi sbagliate che gli ingegneri fanno sulle reti, note come fallacie del calcolo distribuito. La prima è credere che la rete sia affidabile, mentre nella pratica i messaggi si perdono (Rotem-Gal-Oz). Quando un sistema invia una richiesta senza ricevere risposta, non può sapere se è stata elaborata.
- Nessun numero finito di messaggi permette a due sistemi di essere certi di concordare. I sistemi reali affrontano il problema rendendo le operazioni ripetibili senza effetti aggiuntivi e verificandone poi lo stato (Kleppmann, appunti delle lezioni di Cambridge). Un messaggio reinviato fino alla conferma può essere applicato due volte: il corso cita un addebito di 1.000 £ eseguito due volte.
- Stripe ha introdotto chiavi di idempotenza per impedire che un pagamento ripetuto venga addebitato due volte. La chiave va verificata rispetto alla richiesta originale e viene conservata per un tempo limitato (Stripe, documentazione API). Progettare bene questi meccanismi richiede competenza: definire quando due richieste sono identiche, per quanto tempo ricordarle e cosa fare se differiscono. Nulla di questo compare in una richiesta come «collegaci al nostro software contabile». Garantire che un messaggio venga elaborato una volta sola richiede la collaborazione di entrambi i sistemi (Confluent, 2017).
- Per dare un ordine di grandezza, le grandi aziende usano in media 957 applicazioni, di cui il 27% è integrato (MuleSoft 2026). Nel 2025, i loro sviluppatori dedicavano il 39% del tempo a creare nuove integrazioni (MuleSoft 2025).
- Gli errori d’integrazione e migrazione hanno costi misurati. La migrazione di piattaforma di TSB nel 2018 ha provocato 225.492 reclami, 330,2 milioni di sterline di costi successivi alla migrazione e 48,65 milioni di sterline di sanzioni (provvedimento finale FCA, risultati TSB). L’avvio dell’ERP di Revlon in uno stabilimento nel 2018 ha lasciato non spediti circa 64 milioni di dollari di vendite nette e causato 53,6 milioni di dollari di oneri aggiuntivi (Revlon 10-K). Nessuno dei due fallimenti coinvolgeva l’AI. Entrambi dipendevano da come la migrazione era stata pianificata, testata e attuata: attività di progettazione e gestione del progetto che una generazione di codice più veloce non sostituisce.
Generare un connettore è facile. Decidere come si comporta ogni collegamento in caso di messaggi persi, ripetuti o tardivi, e applicare la stessa logica ovunque, è un lavoro di progettazione che precede la scrittura del codice. I dati MuleSoft riguardano aziende con oltre 1.000 dipendenti, non piccoli produttori.
Criterio 7: Conformità
Nel caso migliore: le fatture vengono accettate, le verifiche fiscali superate e i prodotti sono tracciabili.
Nel caso peggiore: fatture scartate, sanzioni e impossibilità di individuare con precisione i lotti da richiamare.
Verdetto
Oggi: per la maggior parte degli obblighi di un ERP, come traccia di audit, esportazioni contabili, tracciabilità, conservazione e blocchi qualità, non esiste uno strumento di verifica automatica. In sua assenza, gli agenti sbagliano spesso: correttezza del 44-76% sulle regole scritte in forma testuale, contro quasi il 100% quando esiste una suite di test ufficiale.
Dal 2027 al 2030: gli agenti diventeranno affidabili negli ambiti con validatori ufficiali, come i formati delle fatture elettroniche (Vericoding, 2025 mostra il passaggio dal 68% al 96% di codice verificato in un anno). Non accadrà lo stesso negli altri ambiti, e continuano ad arrivare nuovi obblighi: fatturazione elettronica per le PMI francesi e passaporti delle batterie nel 2027, passaporti digitali dei prodotti dal 2026. Un’azienda senza personale tecnico che sviluppa l’ERP da zero avrà un sistema apparentemente conforme, finché una verifica fiscale, una fattura scartata o un richiamo non dimostreranno il contrario. Ogni nuovo obbligo richiederà di rileggere la normativa e trasformarla in controlli, senza nessuno in azienda che lo abbia già fatto.
Evidenze
Un’azienda industriale in Europa o negli Stati Uniti deve rispettare un numero crescente di obblighi che il suo ERP deve gestire.
- Stati Uniti: dalla sentenza South Dakota v. Wayfair del 2018, i 45 Stati con un’imposta sulle vendite tassano i venditori a distanza oltre una soglia di vendite. L’ERP deve quindi calcolare l’imposta in base alla destinazione (Corte suprema). I documenti sui beni soggetti a controlli delle esportazioni si conservano per cinque anni (ITAR, EAR). I fornitori della difesa che detengono informazioni non classificate controllate devono rispettare i 110 requisiti del NIST SP 800-171 nell’ambito della Cybersecurity Maturity Model Certification (CMMC), la cui prima fase è iniziata il 10 novembre 2025 (32 CFR 170).
- Alimentare negli Stati Uniti: la norma FSMA 204 richiede un codice di lotto di tracciabilità a ogni evento critico di tracciamento e un file elettronico ordinabile entro 24 ore dalla richiesta della FDA. L’applicazione è prevista non prima del 20 luglio 2028 (21 CFR 1.1455, Public Law 119-37).
- Dispositivi medici: dal 2 febbraio 2026, il regolamento FDA sul sistema qualità incorpora la ISO 13485 e richiede di registrare l’identificativo unico per ogni dispositivo o lotto (FDA, 21 CFR 820.10). Anche il software usato nel sistema qualità deve essere convalidato (21 CFR 11.10, FDA Computer Software Assurance).
- Aerospazio e difesa: AS9100D richiede gestione della configurazione, prevenzione delle parti contraffatte e tracciabilità (IAQG). Le norme statunitensi della difesa richiedono di risalire al produttore originario dei componenti elettronici e mettere in quarantena quelli sospetti (DFARS 252.246-7007).
- Automotive: IATF 16949 richiede piani di tracciabilità documentati che permettano di identificare e separare i prodotti sospetti entro i tempi di risposta di ogni costruttore. Si aggiungono i requisiti specifici pubblicati da BMW, Ford, Renault, Stellantis, Volkswagen e altri (IATF).
- Farmaceutico: l’allegato 11 delle GMP europee richiede sistemi convalidati, controllo degli accessi e una traccia di audit che registri il motivo di ogni modifica. Chiede anche un processo formale di qualità per i sistemi sviluppati su misura o personalizzati (allegato 11). Nell’UE, le confezioni dei medicinali riportano un identificativo unico con codice prodotto, numero di serie, lotto e scadenza (regolamento 2016/161). Negli Stati Uniti, la legge richiede la tracciabilità elettronica a livello di singola confezione dal 2025 (FDA, DSCSA).
- Fatturazione elettronica: tutte le aziende francesi devono poter ricevere fatture elettroniche dal 1° settembre 2026. Le PMI devono emetterle dal 1° settembre 2027 (impots.gouv.fr). Gli strumenti di validazione EN 16931 contengono 223 regole gestionali, più circa 759 regole specifiche per UBL e 587 per CII, aggiornate circa due volte l’anno (CEN/TC 434). In Italia, dove la fatturazione elettronica è obbligatoria dal 2019, nel 2021 veniva ancora scartato l’1,4% di 2,1 miliardi di fatture (Corte dei conti).
- Tracciabilità: le aziende alimentari devono identificare il fornitore e il cliente immediati per ogni lotto (regolamento 178/2002, art. 18) e segnalare 14 gruppi di allergeni (regolamento 1169/2011). I produttori di farmaci e dispositivi medici che vendono negli Stati Uniti devono avere tracce di audit con marca temporale che non nascondano mai i valori precedenti (21 CFR 11.10).
- Verifiche fiscali: le aziende francesi devono consegnare le registrazioni contabili in un file con 18 campi in ordine fisso e numerazione continua e cronologica (LPF, art. A47 A-1), pena una sanzione di 5.000 € o del 10% dell’imposta rideterminata. Le fatture devono essere collegate alle relative consegne da una pista di controllo affidabile (BOFiP).
- Conservazione: i documenti contabili si conservano per dieci anni (Code de commerce, art. L123-22). Durante questo periodo, l’obbligo di conservazione prevale sul diritto alla cancellazione previsto dal GDPR; alla scadenza, i dati devono essere cancellati.
- Nuovi obblighi sui dati: passaporto delle batterie dal 18 febbraio 2027 (Commissione europea) e passaporti digitali dei prodotti per acciaio, tessili, pneumatici e alluminio dal 2026 al 2027 (ESPR).
La capacità degli agenti di applicare correttamente una norma dipende dall’esistenza di una verifica automatica.
- Quando esiste una suite di test completa o un validatore, gli agenti raggiungono ormai una conformità quasi totale. Un team di 16 agenti Claude Opus 4.6 ha creato un compilatore C che supera il 99% delle suite di test standard per compilatori. L’autore sottolinea che il risultato dipende da un verificatore quasi perfetto (Anthropic, febbraio 2026). Un parser HTML5 riscritto in un altro linguaggio con GPT-5.2 in circa 4,5 ore ha superato 6.810 test di tokenizzazione su 6.810 (Willison, dicembre 2025). Nel trasformare una nota clinica in un record clinico FHIR, i modelli raggiungevano al massimo il 50% da soli e fino al 100% con accesso al validatore ufficiale (Flexpa, 2025, 14 casi).
- Quando la norma esiste solo come testo, i risultati sono molto inferiori. Su 100 casi fiscali verificati con una precisione di un dollaro, GPT-5 era corretto 76 volte (Jurayj et al., 2026). Su 6.232 attività di applicazione delle regole in diritto tributario, dell’immigrazione e abitativo, il miglior risultato nel sottoinsieme difficile è il 44% (DeonticBench, aprile 2026). I modelli di punta calcolavano correttamente meno di un terzo delle dichiarazioni fiscali federali statunitensi, anche con tutti i dati forniti (TaxCalcBench, 2025). Il modello migliore assegna i codici di fatturazione medica corretti nel 64% dei casi (Vals.ai MedCode). Nessuno dei cinque chatbot ha prodotto codice conforme allo standard di sicurezza MISRA C++, nonostante prompt espliciti (Umer, IEEE Access 2025).
- Superare i controlli non garantisce che il risultato sia corretto. La verifica formale dimostra che il codice rispetta la specifica ricevuta, non che la specifica rappresenti correttamente la legge (Vericoding, 2025).
Per alcuni obblighi di conformità di un ERP esistono validatori ufficiali, come quelli per le regole EN 16931 sulle fatture elettroniche. Questa parte sta diventando alla portata degli agenti, anche se nessuno studio ha ancora misurato le fatture elettroniche generate da un agente. La fatturazione elettronica pone anche problemi d’integrazione e di sistemi distribuiti: le fatture viaggiano attraverso piattaforme di scambio autorizzate, con conferme, scarti e aggiornamenti di stato da gestire. Richiede quindi sia la corretta applicazione delle norme sia integrazioni affidabili. Molti obblighi non hanno una suite di test: una traccia di audit affidabile, la correttezza dei dati di un’esportazione contabile, la tracciabilità dei lotti o i periodi di conservazione. Qualcuno deve trasformare il testo in controlli e mantenerli aggiornati mentre le regole cambiano ogni anno.
Criterio 8: Manutenzione
Nel caso migliore: il sistema evolve con l’azienda.
Nel caso peggiore: gran parte del budget serve a mantenerlo operativo e si perde la conoscenza del suo funzionamento.
Verdetto
Oggi: il codice scritto con l’AI cresce più velocemente, contiene più duplicazioni ed è più complesso. Chi impara a programmare affidandosi all’AI comprende meno bene il codice.
Dal 2027 al 2030: gli agenti si occuperanno di più correzioni ordinarie. I dati non mostrano che il codice diventi più facile da capire, ma è proprio questa comprensione che serve per mantenerlo. Un’azienda senza personale tecnico che sviluppa il proprio ERP da zero dipenderà dall’agente per ogni correzione. Ciascuna aggiunge codice, spesso copiato da altre parti del sistema. Dopo qualche anno, nessuno in azienda comprende più come funziona l’insieme.
Evidenze
- La manutenzione assorbe il 40-80% del costo del software durante la sua vita (Robert Glass, Facts and Fallacies of Software Engineering, 2002, fatto 41). Gli sviluppatori stimano di dedicarle il 42% del proprio tempo (Stripe, 2018). Questi dati precedono gli agenti di programmazione.
- GitClear ha analizzato 623 milioni di modifiche al codice. La quota di modifiche che migliorano codice esistente è scesa dal 21% nel 2022 al 3,8% nel 2026, mentre quella di codice copiato e incollato è salita dal 9,4% al 15,7% (GitClear 2026, dati di un fornitore che non confrontano utenti AI e non utenti). Quando lo stesso codice esiste in più punti, un bug corretto in uno spesso rimane negli altri.
- I ricercatori hanno confrontato 806 progetti open source che avevano adottato l’editor AI Cursor con 1.380 progetti simili che non lo avevano adottato. I primi scrivevano molto più codice nel primo mese, poi tornavano al ritmo abituale. Il codice diventava però più complesso, generava più segnalazioni negli strumenti automatici di qualità e restava in quelle condizioni (Carnegie Mellon, MSR 2026).
- In uno studio controllato con 151 partecipanti, il codice scritto con l’AI non era più difficile da modificare in seguito per altri sviluppatori (Echoes of AI, 2026).
- In un esperimento controllato con 52 ingegneri, perlopiù a inizio carriera, chi aveva completato un’attività di programmazione con l’AI otteneva il 50% in un successivo test di comprensione, contro il 67% di chi aveva scritto il codice senza AI. Il divario maggiore riguardava le domande sull’individuazione e sulla correzione degli errori (Anthropic, gennaio 2026).
Nessuno studio misura ancora la quota di manutenzione in un sistema creato da agenti. Le ricerche citate mostrano più codice, più duplicazioni e più complessità dopo l’adozione in diversi insiemi di dati, nessun effetto in un esperimento controllato e minori capacità di individuare e correggere gli errori in chi si affida all’AI per imparare.
Criterio 9: Costo
Nel caso migliore: sviluppare costa meno che mai.
Nel caso peggiore: gran parte del costo arriva dopo lo sviluppo: manutenzione, persone che verificano il lavoro degli agenti e costi di utilizzo che crescono a ogni nuova generazione dei modelli migliori.
Verdetto
Oggi: la maggior parte del costo di un ERP riguarda le persone: prima per svilupparlo, poi per mantenerlo per tutta la sua vita, portando il totale a 1,7-5 volte il costo di sviluppo. I modelli incidono poco. Il modello meno costoso che raggiunge un dato punteggio su un benchmark diventa circa 13 volte più economico ogni anno. Il dato è amplificato dall’addestramento dei modelli su quei benchmark. Nel frattempo, ogni attività di programmazione svolta con il modello migliore costa più rispetto a un anno fa.
Dal 2027 al 2030: un ERP viene sviluppato e mantenuto con il miglior modello disponibile al momento. I costi dei modelli seguono quindi la curva crescente, a cui si aggiungono le persone necessarie per verificare il lavoro. Un’azienda senza personale tecnico che sviluppa il proprio ERP da zero vedrà un basso costo iniziale, seguito da costi operativi che crescono con ogni nuovo modello e ogni correzione, e che sostiene da sola. L’opzione meno costosa dipenderà soprattutto dal numero di utenti e dall’esistenza di un team di sviluppo: acquistare preserva la liquidità e comporta costi per utente; sviluppare impegna liquidità e personale, ma può costare meno con molti utenti.
Evidenze
Nell’intero ciclo di vita di un ERP, il costo è soprattutto quello delle persone. I modelli ne rappresentano una piccola parte.
- La manutenzione assorbe il 40-80% del costo complessivo di un sistema (Glass, vedi Manutenzione). Un sistema sviluppato internamente costa quindi 1,7-5 volte il costo iniziale durante la sua vita. Gli agenti riducono soprattutto lo sviluppo, mentre i dati mostrano una riduzione minore della manutenzione.
- Lo sviluppo si paga soprattutto in stipendi. A maggio 2025, lo stipendio mediano di uno sviluppatore negli Stati Uniti era di 135.980 $ (BLS). Gli stipendi rappresentano il 68,5% di quanto un datore di lavoro paga per un dipendente privato a tempo pieno (BLS, giugno 2026). Uno sviluppatore costa quindi circa 200.000 $ l’anno. A 13 $ per giorno di utilizzo, un agente di programmazione AI aggiunge circa 3.000 $ l’anno per sviluppatore.
- L’acquisto si paga soprattutto con un abbonamento per utente, più i costi di implementazione della piattaforma, il cui budget viene superato da oltre un quarto delle aziende (Panorama Consulting, 2026).
Le due opzioni impiegano la liquidità in modo diverso. Acquistare richiede pochi fondi iniziali e trasforma l’ERP in un costo ricorrente per utente. Sviluppare richiede subito liquidità per gli stipendi durante il progetto e poi costi fissi di personale finché il sistema resta operativo. Secondo gli IFRS, i costi di sviluppo del software interno possono essere iscritti tra le attività quando il progetto soddisfa le condizioni dello IAS 38. La configurazione del software in abbonamento viene invece generalmente spesata man mano che il lavoro viene svolto (IFRIC, 2021). Gli US GAAP consentono di capitalizzare alcuni costi d’implementazione del software cloud (ASU 2018-15).
L’opzione meno costosa dipende soprattutto dal numero di utenti: il costo dell’abbonamento cresce con il numero di utenti, quello del sistema interno con le dimensioni del team. Per esempio, se un solo sviluppatore potesse creare e mantenere l’ERP, l’abbonamento annuale costerebbe quanto quello sviluppatore con circa 330 utenti a 50 $ per utente al mese, 170 utenti a 100 $ e 80 utenti a 200 $. L’esempio esclude i costi d’implementazione della piattaforma da un lato e la probabilità che uno sviluppatore non basti dall’altro.
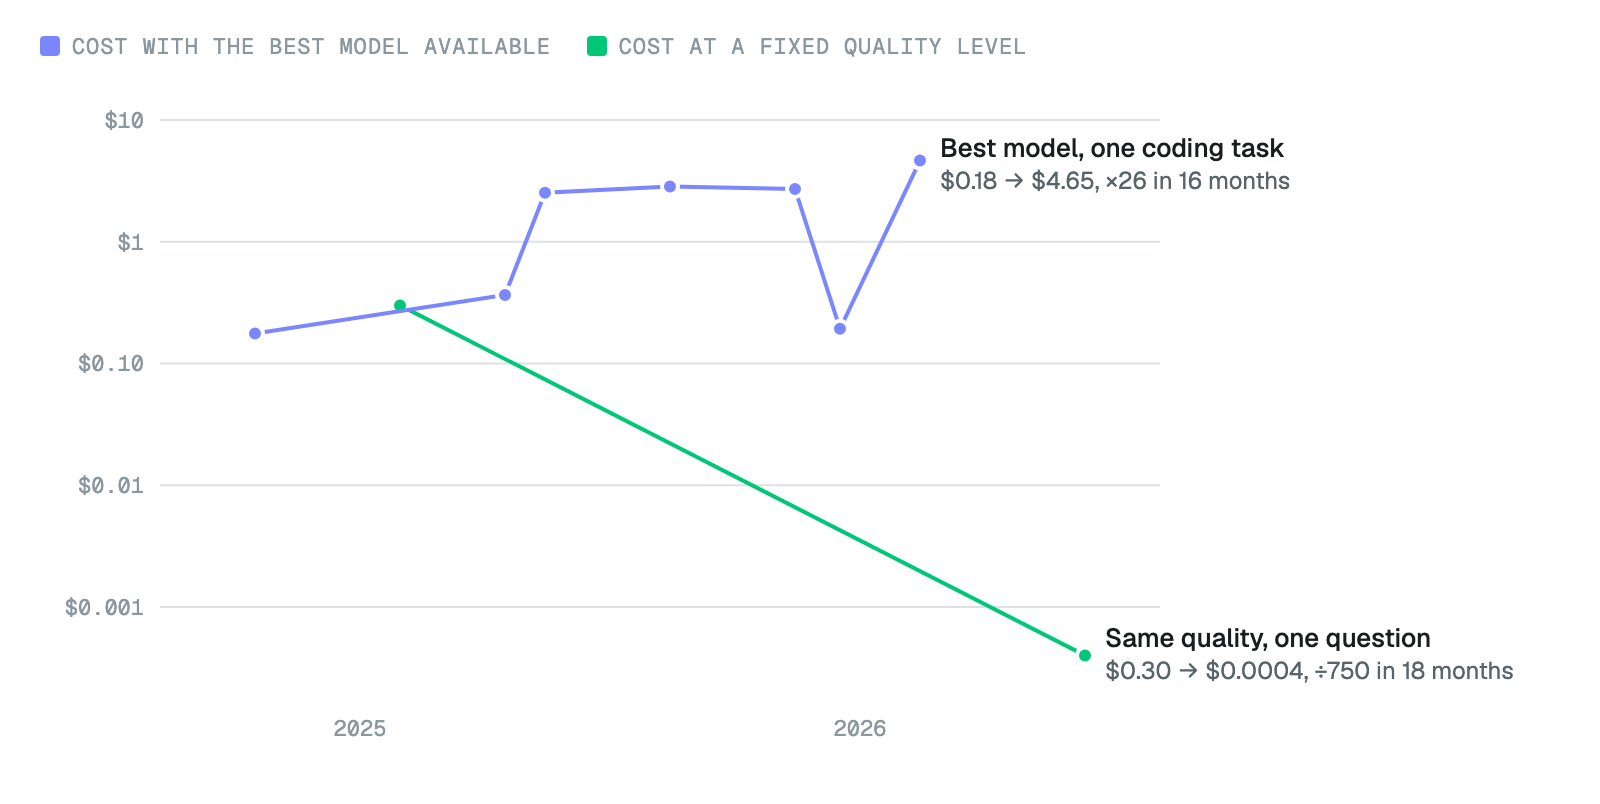
I costi dei modelli si aggiungono agli altri e seguono due tendenze contemporaneamente.
- Il prezzo di un dato livello di capacità scende di circa il 47% a trimestre, cioè di circa 13 volte l’anno (Epoch AI, settembre 2026).
- Rispondere a una domanda scientifica al livello di o3 costava 0,30 $ a gennaio 2025 e 0,0004 $ a metà 2026. Il dato può risentire dell’ottimizzazione dei modelli per i benchmark, come riconoscono gli autori. La misura segue il modello meno costoso che raggiunge un dato punteggio, ma i laboratori possono addestrare i modelli su alcuni di quei test. Nell’unico test i cui contenuti non sono pubblici, il prezzo scende più lentamente.
- Il modello meno costoso che raggiunge un punteggio raramente è un modello di punta. Quando un test pubblico di matematica è stato riscritto con nuove domande della stessa difficoltà, diverse famiglie di modelli hanno mostrato un sovradattamento sistematico alle domande note, mentre i modelli di punta ne mostravano poco (GSM1k, 2024). Il calcolo presuppone anche che l’utente passi al modello meno costoso ogni trimestre. Il dato mostra che ottenere un punteggio su un benchmark costa meno, non che costi meno svolgere lo stesso lavoro.
- Il costo del miglior modello disponibile aumenta nelle attività di programmazione, perché ogni generazione usa molti più token per attività. Un’esecuzione di SWE-bench Verified con il modello migliore costava 88 $ a ottobre 2024 e 2.323 $ a febbraio 2026 (MIT FutureTech, dati). Le risposte dei modelli di ragionamento diventano circa cinque volte più lunghe ogni anno (Epoch AI). Sulle domande scientifiche, il costo del modello migliore ha raggiunto il massimo a dicembre 2024 e da allora è rimasto intorno a 0,07-0,10 $ per domanda.

Tra Claude Opus 4.8 e Opus 5.5, il prezzo per token è sceso del 20%, i token usati sono aumentati del 50% e il costo dello stesso test è salito del 27% (Artificial Analysis). Anthropic stima il costo di Claude Code in circa 13 $ per sviluppatore per giorno di utilizzo (Claude Code).
Con i progressi dei modelli, raggiungere i vecchi punteggi dei benchmark costa meno, mentre usare i modelli più avanzati costa di più per attività. La seconda tendenza è più solida, perché misura ciò che i modelli consumano anziché i loro punteggi. Un ERP ha bisogno del modello più affidabile disponibile, perché gli errori costano cari.
Criterio 10: Adattabilità
Nel caso migliore: il software gestisce i processi dell’azienda anziché imporne di generici.
Nel caso peggiore: processi piegati alle esigenze del software, oppure modifiche al nucleo condiviso che compromettono altre funzioni o espongono dati.
Verdetto
Oggi: un ERP sviluppato su misura risponde esattamente alle esigenze dell’azienda. Le piattaforme differiscono: alcune si adattano solo tramite codice nel nucleo, da rivedere a ogni aggiornamento; altre, come Bonx, consentono adattamenti sui dati dell’azienda che restano validi dopo gli aggiornamenti.
Dal 2027 al 2030: l’AI riduce il costo degli adattamenti per entrambe le opzioni, restringendo il divario per le piattaforme progettate per essere adattate in sicurezza. Un’azienda senza personale tecnico che sviluppa il proprio ERP da zero ottiene un sistema perfettamente aderente ai processi il primo giorno. Che lo sia ancora cinque anni dopo dipende dagli altri criteri: un’architettura modificabile, regole che restano corrette e qualcuno in grado di mantenerlo.
Evidenze
- In un’indagine del 2013 tra utenti ERP, il 38% aveva modificato i processi per adattarli al software e il 29% aveva modificato il software per conservare i processi (Panorama 2013).
- Nessuno studio pubblicato misura la quota di esigenze aziendali coperta dalle funzioni standard di un ERP. Il dato del 70%, spesso citato, non ha una fonte rintracciabile.
- Odoo, un ERP open source molto diffuso, può essere adattato in due modi:
- Odoo Studio aggiunge campi, viste, modelli, automazioni e report senza codice (Odoo Studio).
- Oltre questo ambito, gli adattamenti sono moduli Python che estendono il nucleo.
- Odoo pubblica una versione principale l’anno e richiede un aggiornamento almeno ogni due anni. Chi mantiene ogni modulo personalizzato deve renderlo compatibile con la nuova versione, a meno che il cliente non paghi Odoo un canone mensile ogni 100 righe di codice personalizzato per farlo (documentazione sugli aggiornamenti Odoo, contratto Odoo Enterprise).
Un ERP sviluppato internamente nasce per rispondere alle esigenze dell’azienda: è il suo vantaggio principale. In una piattaforma, l’adattabilità dipende da meccanismi che permettano di aggiungere campi, tabelle, schermate e regole sui propri dati senza toccare il nucleo condiviso. Permessi e isolamento devono impedire che un adattamento comprometta altre funzioni o esponga dati.
L’AI riduce il costo di questi adattamenti. La loro sicurezza deriva dai meccanismi della piattaforma, non dal modello. Il modo in cui vengono realizzati ne determina anche il costo nel tempo. Se richiedono modifiche al codice centrale della piattaforma, ciascuno comporta ulteriore lavoro a ogni aggiornamento, come mostrano le condizioni di Odoo. Se vengono realizzati sui dati dell’azienda attraverso meccanismi mantenuti dalla piattaforma, superano gli aggiornamenti senza dover essere riscritti.
Criterio 11: Nuove funzionalità
Nel caso migliore: software che svolge parte del lavoro invece di limitarsi a registrarlo. Per esempio, piani che si ricalcolano quando cambia un ordine, documenti dei fornitori letti e inseriti senza digitazione, attività amministrative ordinarie eseguite senza intervento umano.
Nel caso peggiore: un’azienda che sviluppa da sola arriva, nel migliore dei casi, fin dove il proprio team sa progettare e verificare. Di solito significa ricostruire un ERP standard mentre gli altri avanzano.
Verdetto
Oggi: gli ingegneri esperti ottengono quasi tutti i miglioramenti di produttività e nella capacità di esplorare nuovi ambiti offerti dall’AI. Valutare ciò che produce richiede competenza. Nella manifattura, l’AI ha dato risultati dopo un calo iniziale e solo con il lavoro organizzativo necessario ad accompagnarla.
Dal 2027 al 2030: tutti avranno gli stessi modelli. Il divario dipenderà da ciò che verrà costruito con essi. Confrontiamo due aziende manifatturiere simili per capire cosa significa. È uno scenario costruito sui dati di questa analisi, non una misurazione.
Evidenze
| Periodo | Sviluppa con agenti, senza team di sviluppo | Acquista una piattaforma adattabile |
|---|---|---|
| Primi mesi | Prime schermate in poche settimane, perché gli agenti riescono quasi sempre a creare un’applicazione nuova. | Parte da funzioni già usate e testate da altri produttori, attraverso un progetto d’implementazione. Oltre un quarto di questi progetti supera il budget: l’implementazione merita quindi la stessa cura dello sviluppo. |
| Anni 1-2 | Ogni modifica rischia di compromettere ciò che funzionava: 34% di successo nell’evoluzione di un’applicazione e regressioni nel 39% dei fallimenti. Gli sforzi vanno alle correzioni. | Adatta la piattaforma ai propri processi senza toccare il nucleo. Correzioni, patch di sicurezza e aggiornamenti normativi arrivano dal fornitore, insieme a nuove funzioni create da un team che sfrutta meglio gli stessi modelli. |
| Anno 5 | La manutenzione assorbe gran parte del budget, il 40-80%. Il sistema fa ciò che l’azienda sapeva specificare nel primo anno. | L’ERP ha continuato a migliorare senza essere sviluppato o mantenuto dall’azienda. Il team interno si concentra sui processi. L’azienda dipende dal fornitore per aggiornamenti, prezzi e assistenza: scegliere il fornitore diventa quindi la decisione principale. |
Il confronto si ribalta quando l’azienda che sviluppa dispone di un proprio team di sviluppo e di prodotto, oppure quando circa l’80% delle esigenze è specifico. Può allora creare funzionalità che nessuna piattaforma offre e trasformarle in un vantaggio proprio.
Proiezione: il divario è massimo se la piattaforma è davvero AI-native, con un’AI che svolge autonomamente gran parte del lavoro amministrativo. Nessuno studio pubblicato lo ha ancora misurato in un ERP reale. La proiezione seguente poggia quindi su un’ipotesi: l’AI dell’ERP svolge l’80% del lavoro amministrativo e i suoi controlli sostituiscono gran parte della verifica umana. È un’ipotesi forte. Con i modelli del 2025, verificare e rifare il lavoro dell’AI annullava quasi tutto il tempo risparmiato (GDPval, vedi l’ipotesi di base).
Nella manifattura statunitense, il personale delle funzioni aziendali, finanziarie, d’ufficio e amministrative rappresentava il 12,6% dei dipendenti e percepiva 90 miliardi di dollari di stipendi nel 2021 (BLS), a fronte di 6.100 miliardi di dollari di produzione spedita (Census), circa 500.000 $ per dipendente. Includendo gli oneri del datore di lavoro, le funzioni amministrative costano circa il 2% dei ricavi.
Consideriamo un produttore con 100 dipendenti, 50 milioni di dollari di ricavi e un margine operativo dell’8%, nella fascia delle aziende manifatturiere statunitensi quotate: dal 4% nell’acciaio al 16% nei macchinari (Damodaran, gennaio 2026). Le funzioni amministrative contano circa 13 persone e costano circa 1,1 milioni di dollari l’anno. Si assume che l’azienda che sviluppa paghi uno sviluppatore e non raggiunga lo stesso livello di automazione, perché concentra gli sforzi sulle funzioni standard. Si assume che quella che acquista paghi 100 $ per utente al mese per 30 utenti.
| Indicatore | Sviluppa da zero | Acquista un ERP AI-native |
|---|---|---|
| Costo delle funzioni amministrative | Circa 1,1 milioni di dollari | Circa 200.000 $, equivalenti a 10 persone riassegnate o non sostituite |
| Costo dell’ERP | Circa 200.000 $ per uno sviluppatore | Circa 36.000 $ di abbonamento |
| Risultato operativo | Circa 3,8 milioni di dollari | Circa 4,8 milioni di dollari |
| Margine operativo | Circa il 7,6% | Circa il 9,7% |
Con queste ipotesi, l’azienda che acquista ottiene ogni anno un risultato operativo superiore di circa un quarto rispetto a quella che sviluppa, e circa il 55% in più se entrambe partono da un margine del 4%. La proiezione esclude i costi d’implementazione di entrambe le opzioni e ogni effetto sui ricavi, come preventivi più rapidi o meno consegne in ritardo, che nessuno studio ha ancora misurato. I dati industriali riportati di seguito suggeriscono anche che i guadagni arrivano dopo un periodo di adattamento.
Tutti hanno accesso agli stessi modelli. Cambiano ciò che viene costruito con essi e chi lo costruisce.
- Su 160.097 sviluppatori GitHub, l’AI scrive circa il 29% delle funzioni Python negli Stati Uniti. I programmatori che usano l’AI esplorano più facilmente nuovi ambiti software. Quelli esperti ottengono quasi tutti questi miglioramenti di produttività e nella capacità di esplorare nuovi ambiti, mentre quelli a inizio carriera non mostrano benefici significativi (Daniotti et al., Science 2026).
- Esperimenti controllati precedenti su attività ordinarie indicano il contrario. In Microsoft, Accenture e un’azienda Fortune 100, gli sviluppatori meno esperti adottavano di più Copilot e miglioravano maggiormente la propria produttività, anche se la differenza non era statisticamente significativa (Cui, Demirer et al.). Nell’assistenza clienti, la produttività dei principianti aumentava del 34%, contro il 14% medio (Brynjolfsson et al., NBER 2023).
- Valutare il risultato dell’AI richiede competenza. I responsabili dei progetti rifiuterebbero circa metà delle correzioni degli agenti che superano i test automatici (METR, marzo 2026). Correggere una modifica di un agente richiedeva in media 26-42 minuti (METR, agosto 2025). Le modifiche presentate da sviluppatori meno esperti con l’AI ricevevano 4,52 volte più commenti di revisione e venivano accettate il 31% meno spesso (studio su 22.953 richieste d’integrazione del codice, 2026).
- Nella manifattura statunitense, gli stabilimenti che adottavano l’AI industriale perdevano inizialmente produttività, con un aumento dei semilavorati in corso di lavorazione, investimenti in robot e riduzioni del personale, per poi crescere più velocemente degli altri. Le perdite erano concentrate nelle aziende più vecchie e attenuate da strategie orientate alla crescita (McElheran, Yang, Kroff e Brynjolfsson, documento di lavoro, 2025). L’AI cambia le prestazioni di uno stabilimento solo con il lavoro organizzativo che la accompagna.
- Il rapporto DORA 2025 descrive l’AI come un amplificatore dei punti di forza e di debolezza già presenti nell’organizzazione (DORA 2025).
Le evidenze cambiano a seconda di ciò che viene misurato. I principianti migliorano di più nelle attività brevi e ordinarie. Gli esperti migliorano di più nel lavoro reale, esplorano più possibilità e sanno verificare il risultato. Creare funzionalità che prima non esistevano è proprio questo tipo di lavoro.
Cosa succede nel tempo se sviluppi internamente
Se decidi di sviluppare, la tabella seguente mostra come cambia tipicamente la situazione dai primi mesi al quinto anno. È una mappa dei compromessi da aspettarsi e dei problemi da prevenire già in fase di progettazione.
| Criterio | Primi mesi | Dopo 1-2 anni | Dopo 5 anni |
|---|---|---|---|
| Progettazione tecnica | Le funzioni vengono sviluppate rapidamente | Ogni modifica diventa più lenta e rischiosa | Riscrittura parziale o totale |
| Regole gestionali | Piccoli errori nei totali e nelle scorte | Margini e valori delle scorte errati in contabilità | Bilanci errati, impossibilità di individuare i lotti da richiamare |
| Sicurezza | Dati o chiavi esposti | Intrusione o ransomware | Produzione ferma per settimane dopo un solo incidente |
| Prestazioni | Veloce sui dati di test | Schermate lente, elaborazioni notturne che non terminano in tempo | Riprogettazione dell’architettura |
| Affidabilità e protezione dei dati | Interruzioni durante i rilasci | Un incidente con perdita di dati | Lacune nello storico di scorte e ordini |
| Integrazioni | Reinserimenti manuali e duplicati | Discrepanze non segnalate con contabilità e clienti | Ogni nuovo collegamento costa quanto il primo |
| Conformità | Fatture scartate | Sanzioni durante una verifica fiscale | Nuovi obblighi non implementati |
| Manutenzione | Pochi problemi | Gran parte del lavoro assorbita dalle correzioni | Un sistema che nessuno comprende |
| Costo | Basso costo di sviluppo | I costi operativi superano quelli di sviluppo | Gran parte del costo totale riguarda la gestione |
| Adattabilità | Soluzioni alternative nei fogli di calcolo | Processi piegati alle esigenze del software | Software aggirato o abbandonato |
| Nuove funzionalità | Funzioni standard ricostruite una alla volta | Nessuna funzione oltre quelle specificate | Ritardo sui concorrenti il cui ERP ha continuato a migliorare |
Cosa significa per te
I modelli continueranno a ridurre il costo del codice. Non sostituiscono però l’esperienza di gestire un ERP negli anni: mantenere coerente l’architettura, applicare correttamente le regole gestionali e far funzionare il sistema. La domanda decisiva, quindi, è chi si assumerà la responsabilità del tuo ERP, lo testerà e lo farà evolvere dopo che l’AI lo avrà creato.
Cosa tenere a mente
- L’AI rende più facili le parti semplici, non quelle più difficili: un’architettura coerente negli anni, regole gestionali non scritte, gestione operativa, integrazioni e conformità.
- I team esperti ottengono di più dall’AI. Il divario tra un team che gestisce ERP da anni e un’azienda che crea il suo primo ERP tende quindi ad ampliarsi.
- Sviluppare conviene quando la maggior parte delle esigenze è specifica della tua azienda. Negli altri casi, acquista una piattaforma adattabile e sviluppa su quella la parte specifica.
- Usa gli 11 criteri per valutare la tua situazione e prepara le risposte ai problemi della tabella prima che si presentino.
Acquista la piattaforma. Sviluppa la parte che è solo tua.
Per la maggior parte dei produttori, la ricerca porta a una sola risposta: acquistare una piattaforma adattabile e sviluppare sopra, con l’AI, la parte specifica per te. Bonx è l’ERP manifatturiero AI-native, progettato proprio per questo.
Si adatta al tuo stabilimento, non il contrario
I tuoi responsabili modificano il modello dati, i processi, le automazioni, gli agenti AI e le schermate, senza codice e senza consulenti. Circa il 90% delle operazioni gira sui moduli standard. Il resto viene sviluppato come app dentro Bonx, testata in bozza e pubblicata quando decidi tu.
«Bonx si è adattato al nostro sistema, non il contrario.» David Nicolas, Féroce
Si implementa in settimane, non in anni
Un primo go-live in 10 settimane in media e un go-live completo in 4-6 mesi, contro i 12-24 mesi di un ERP tradizionale. In Féroce il go-live è avvenuto in 42 giorni, senza interrompere le operazioni. Come Bonx si implementa molto più in fretta di un ERP tradizionale
Si integra con gli strumenti che usi già
Un unico sistema per ordini, magazzino, acquisti, pianificazione, produzione, qualità, logistica e fatturazione, collegato a CRM, e-commerce e strumenti di contabilità. Nervures ha ridotto del 95% il reinserimento manuale dei dati in produzione e logistica.
Guarda il tuo processo più difficile in Bonx
Porta il processo che pensavi di sviluppare. Ti mostreremo come funzionerebbe in Bonx e in quali casi sviluppare sopra ha ancora senso. Non sai in quale situazione rientra la tua azienda? Possiamo esaminare insieme i criteri.